Descripción
Grafana Alloy ofrece pipelines nativas para OTel, Prometheus, Pyroscope, Loki y otras herramientas de monitoreo. Esto significa que puedes recopilar y procesar datos de múltiples fuentes de forma eficiente. Además, puedes utilizar Alloy para realizar diversas tareas, como configurar reglas de alerta en Loki y Mimir.
Alloy es totalmente compatible con OTel Collector, Prometheus Agent y Promtail. Puedes usar Alloy como una alternativa a estas soluciones o integrarlo en un sistema híbrido con múltiples colectores y agentes. Su flexibilidad te permite desplegarlo en cualquier lugar dentro de tu infraestructura de TI.
Alloy es más que solo señales de observabilidad como métricas, logs y trazas. Proporciona muchas características que te ayudan a encontrar y procesar rápidamente tus datos en entornos complejos. Algunas de estas características incluyen componentes personalizados, compatibilidad con GitOps, soporte para clústeres, seguridad y herramientas de depuración.
Resumen de funciones más importantes
- Pipelines Nativas: Grafana Alloy ofrece pipelines nativas para OTel, Prometheus, Pyroscope, Loki y muchas otras herramientas de métricas, logs, trazas y perfiles.
- Retención de Datos en Caso de Pérdida de Conectividad: Alloy conserva los datos recopilados hasta que se restablece la conectividad y luego los envía al backend, asegurando que no se pierda información crucial.
- Configuración de Reglas de Alerta: Permite configurar reglas de alerta en Loki y Mimir, facilitando la detección temprana de eventos importantes y la respuesta rápida a incidentes.
- Compatibilidad Total con Herramientas Existentes: Es totalmente compatible con OTel Collector, Prometheus Agent y Promtail, lo que te permite integrarlo fácilmente en tu infraestructura actual.
- Flexibilidad en el Despliegue: Puedes desplegar Alloy en cualquier parte de tu infraestructura de TI, ya sea on-premise, en la nube o en entornos híbridos.
- Integración con Backends Múltiples: Se puede emparejar con el stack LGTM de Grafana, utilizarse con Grafana Cloud o conectarse a cualquier otro backend compatible de otros proveedores.
- Sistema Híbrido de Colectores y Agentes: Puedes combinar Alloy con múltiples colectores y agentes para crear un sistema de monitoreo robusto y personalizado.
- Escalabilidad: Diseñado para manejar grandes volúmenes de datos, Alloy es adecuado para infraestructuras de cualquier tamaño.
- Configuración Personalizable: Ofrece opciones de configuración flexibles para adaptarse a las necesidades específicas de tu entorno y casos de uso.
- Eficiencia en el Procesamiento de Datos: Optimiza la recopilación y procesamiento de métricas, logs, trazas y perfiles, mejorando el rendimiento general del sistema.
- Seguridad Mejorada: Proporciona mecanismos de seguridad para proteger la integridad y confidencialidad de los datos durante su transmisión y almacenamiento.
- Monitoreo Unificado: Centraliza el monitoreo de diferentes tipos de datos, facilitando su análisis y correlación.
Resumen del Uso de Recursos de Grafana Alloy
- Métricas de Prometheus:
- Por cada 1 millón de series activas con el intervalo de recopilación predeterminado:
- 0.4 núcleos de CPU
- 11 GiB de memoria
- 1.5 MiB/s de ancho de banda de red total (envío y recepción)
- Por cada 1 millón de series activas con el intervalo de recopilación predeterminado:
- Logs de Loki:
- Por cada 1 MiB/segundo de logs ingeridos:
- 1 núcleo de CPU
- 120 MiB de memoria
- Factores que pueden aumentar el uso de recursos:
- Número de etiquetas
- Cantidad de archivos
- Longitud promedio de las líneas de log
- Overhead de ejecutar Alloy en múltiples nodos pequeños
- Por cada 1 MiB/segundo de logs ingeridos:
- Perfiles de Pyroscope:
- Por cada 100 perfiles/segundo:
- 1 núcleo de CPU
- 10 GiB de memoria
- Factores adicionales:
- Tamaño de cada perfil
- Frecuencia de obtención de perfiles
- Por cada 100 perfiles/segundo:
Instalación para equipo Ubuntu/Debian
Los paquetes disponibles estan aquí:
Para instalarlo es tan sencillo como:
# descargamos paquete
wget https://github.com/grafana/alloy/releases/download/v1.4.1/alloy-1.4.1-1.amd64.deb
# instalamos el paquete descargado
sudo dpkg -i alloy-1.4.1-1.amd64.deb
Cambiar usuario, lanzarlo como root
Aunque no requiere permisos de
root para correr el demonio, el propio paquete lo hace como usuario alloy . En algunos casos puede ser necesario lanzarlo como root para hacer esto en Ubuntu podemos hacer:sudo systemctl edit alloy.serviceesto nos llevará a una pantalla como esta:
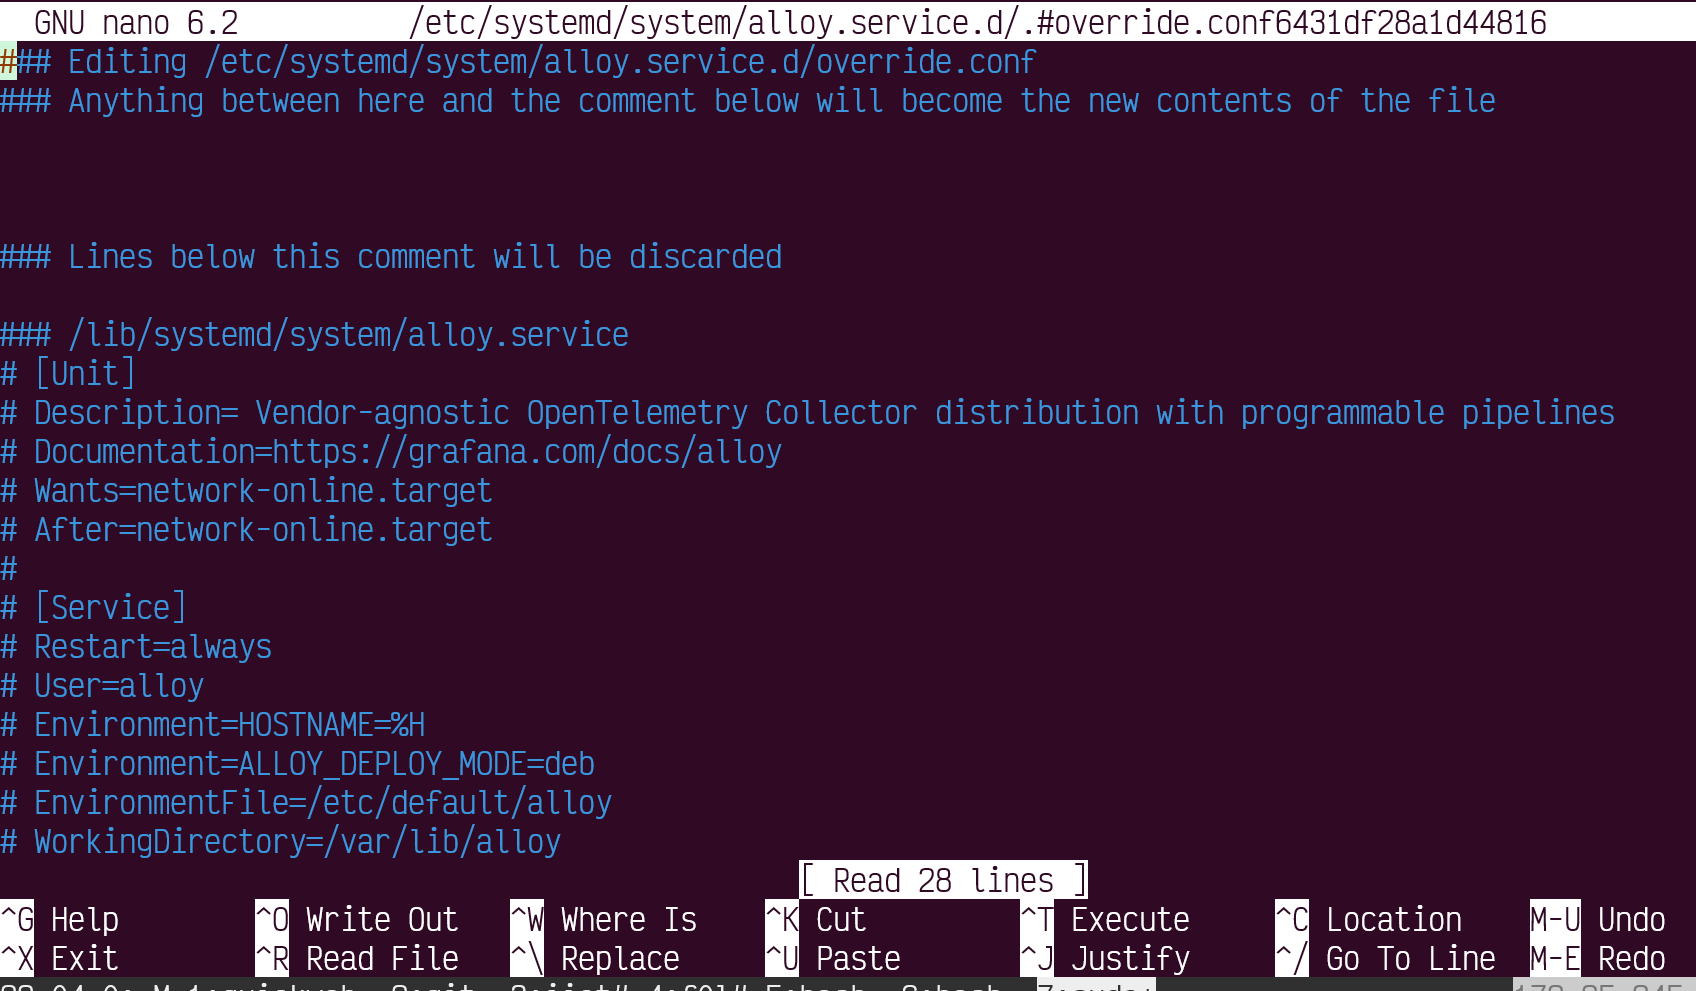
donde podemos escribir, por ejemplo:
[Service]
User=root
quedaría así:
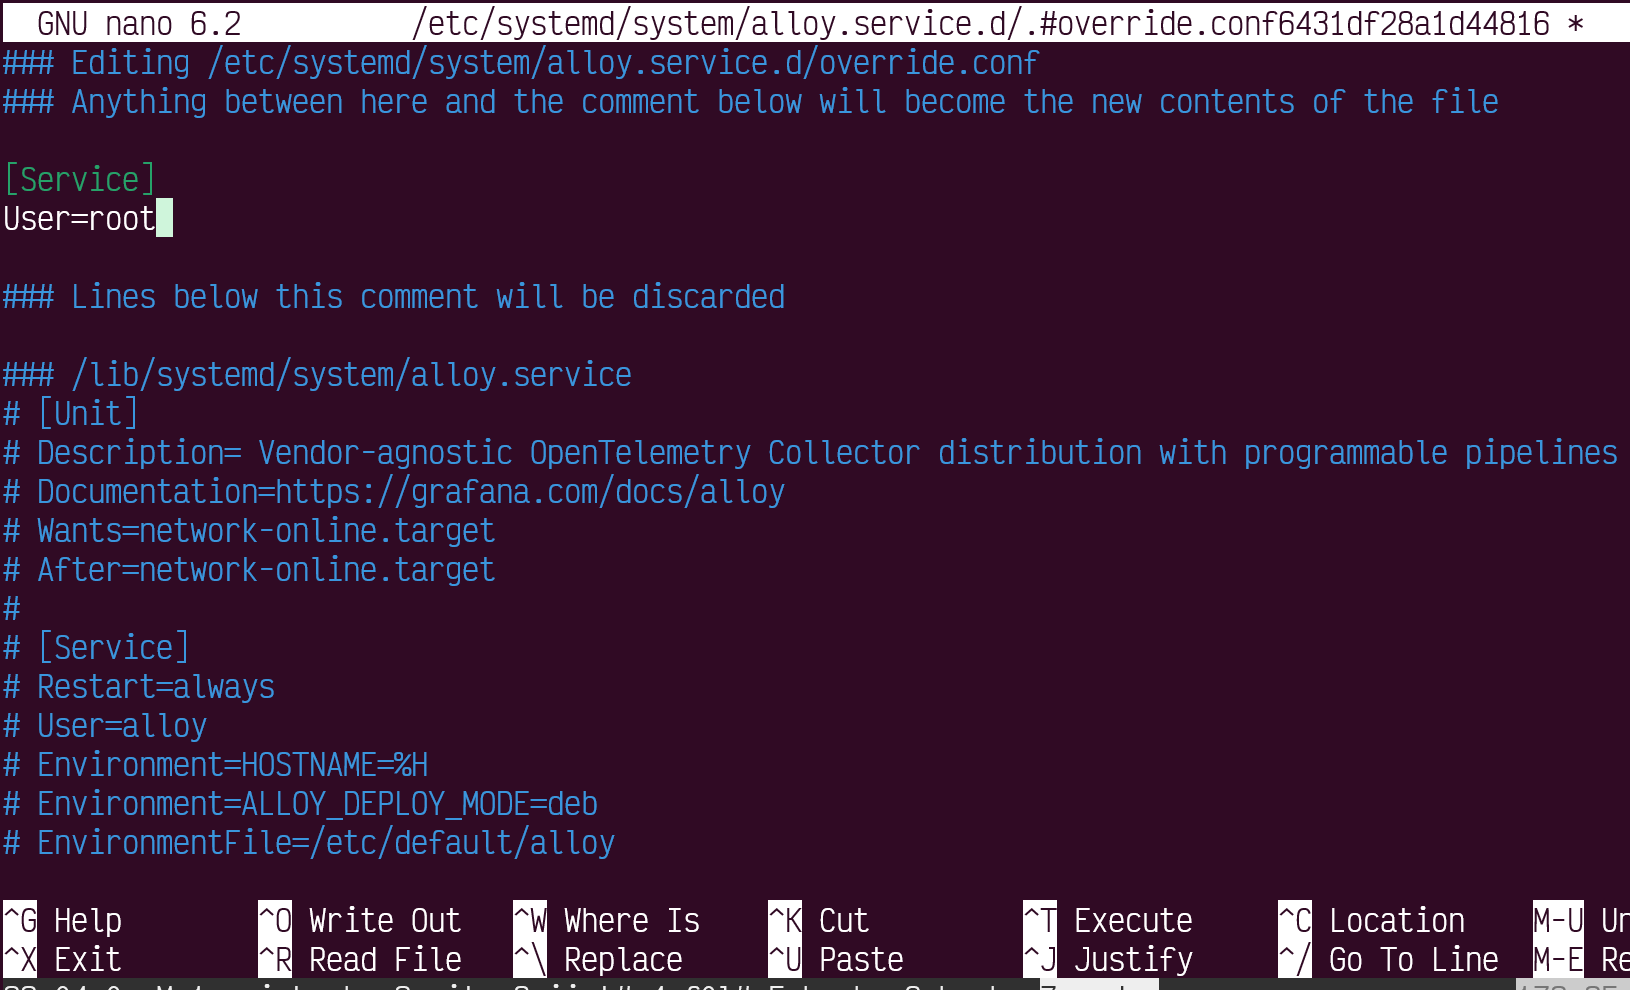
Guardamos y esto habrá creado el fichero
/etc/systemd/system/alloy.service.d/override.conf .Seguidamente debemos recargar la configuración y reiniciar el servicio:
sudo systemctl daemon-reload

sudo systemctl restart alloy.service
Configuración de Grafana Alloy
Nuestro fichero de configuración
logging {
  level  = "warn"
  format = "logfmt"
}

livedebugging {
  enabled = true
}

prometheus.exporter.self "alloy" {}

prometheus.scrape "alloy" {
	targets    = prometheus.exporter.self.alloy.targets
	forward_to = [prometheus.remote_write.mimir.receiver]
}

discovery.docker "containers" {
  host = "unix:///var/run/docker.sock"
}

prometheus.scrape "containers_scraper" {
  targets    = discovery.docker.containers.targets
	forward_to = [prometheus.remote_write.mimir.receiver]
}

prometheus.exporter.cadvisor "cadvisor_export" {
  docker_host = "unix:///var/run/docker.sock"

  storage_duration = "1m"
}

// Configure a prometheus.scrape component to collect cadvisor metrics.
prometheus.scrape "cadvisor_scraper" {
  targets    = prometheus.exporter.cadvisor.cadvisor_export.targets
  forward_to = [ prometheus.remote_write.mimir.receiver ]
}

prometheus.exporter.unix "linux_exporter" { }

// Configure a prometheus.scrape component to collect unix metrics.
prometheus.scrape "linux_scraper" {
  targets    = prometheus.exporter.unix.linux_exporter.targets
  forward_to = [prometheus.remote_write.mimir.receiver]
}

discovery.relabel "logs_default_syslog" {
	targets = []

	rule {
		source_labels = ["__syslog_message_hostname"]
		target_label  = "instance"
    replacement   = "k5"
	}

	rule {
		source_labels = ["__syslog_message_severity"]
		target_label  = "level"
	}

	rule {
		source_labels = ["__syslog_message_app_name"]
		target_label  = "application"
	}

	rule {
		source_labels = ["__syslog_message_facility"]
		target_label  = "facility"
	}
}

loki.relabel "journal_relabel" {
  forward_to = []

  rule {
    source_labels = ["__journal__systemd_unit"]
    target_label  = "unit"
  }
}

loki.source.journal "journal_source"  {
  forward_to = [loki.write.logs_default.receiver]
  relabel_rules = loki.relabel.journal_relabel.rules
  labels        = {component = "loki.source.journal"}
}

loki.source.syslog "logs_default_syslog" {
	listener {
		address      = "127.0.0.1:1514"
		protocol     = "udp"
		idle_timeout = "60s"
		labels       = {
			job = "syslog",
		}
		max_message_length = 8192
	}
  // forward_to = [loki.write.logs_default.receiver]
  forward_to = [loki.process.logs_default_syslog.receiver]
	relabel_rules = discovery.relabel.logs_default_syslog.rules
}

loki.process "logs_default_syslog" {
  forward_to = [loki.write.logs_default.receiver]

  stage.drop {
    older_than = "24h"
    drop_counter_reason = "too old"
  }

  stage.drop {
    longer_than         = "8KB"
    drop_counter_reason = "too long"
  }
}

discovery.docker "logs_default_docker" {
	host = "unix:///var/run/docker.sock"
}


loki.process "logs_default_docker" {
	forward_to = [loki.write.logs_default.receiver]

  stage.drop {
    older_than = "24h"
    drop_counter_reason = "too old"
  }

  stage.drop {
    longer_than         = "8KB"
    drop_counter_reason = "too long"
  }

	stage.match {
		selector = "{container_name=\"emqx\"}"

		stage.json {
			expressions = {
				level = "level",
			}
		}

		stage.labels {
			values = {
				level = null,
			}
		}
	}

	stage.match {
		selector = "{container_name=\"hasura\"}"

		stage.json {
			expressions = {
				level = "level",
			}
		}

		stage.labels {
			values = {
				level = null,
			}
		}
	}

	stage.match {
		selector = "{container_name=\"influx2\"}"

		stage.regex {
			expression = "lvl=(?P<level>\\w+)"
		}

		stage.labels {
			values = {
				level = null,
			}
		}
	}
}

discovery.relabel "logs_default_docker" {
	targets = []

	rule {
		source_labels = ["__meta_docker_container_id"]
		target_label  = "container_id"
	}

	rule {
		source_labels = ["__meta_docker_container_name"]
		regex         = "/(.*)"
		target_label  = "container_name"
	}

	rule {
		source_labels = ["__meta_docker_network_ip"]
		target_label  = "container_ip"
	}

	rule {
		target_label = "instance"
		replacement  = "k5"
	}

	rule {
		target_label = "application"
		replacement  = "docker"
	}
}

loki.source.docker "logs_default_docker" {
	host          = "unix:///var/run/docker.sock"
	targets       = discovery.docker.logs_default_docker.targets
	forward_to    = [loki.process.logs_default_docker.receiver]
	relabel_rules = discovery.relabel.logs_default_docker.rules
}

prometheus.remote_write "mimir" {
	endpoint {
    url = "https://metrics.i40sys.com/api/v1/push"
	}
}

loki.write "logs_default" {
	endpoint {
		url = "https://logs.i40sys.com/loki/api/v1/push"
    min_backoff_period = "1s"
    max_backoff_period = "1m"
    max_backoff_retries = 10
	}
	external_labels = {}
  wal {
    enabled = true
    max_segment_age = "1h"
  }
}
Esta configuración hace una:
- Recopilación de métricas:
- Métricas del propio Alloy
- Métricas de contenedores Docker
- Métricas de cAdvisor (para monitoreo detallado de contenedores)
- Métricas del sistema Linux
- Recopilación de logs:
- Logs del sistema (syslog)
- Logs del journal de systemd
- Logs de contenedores Docker
- Procesamiento de logs:
- Filtrado de logs antiguos (más de 24 horas)
- Limitación del tamaño de los logs
- Procesamiento específico para logs de contenedores EMQX, Hasura e InfluxDB
- Destino de los datos:
- Métricas: Se envían a un endpoint Mimir remoto (https://metrics.i40sys.com/api/v1/push)
- Logs: Se envían a un endpoint Loki remoto (https://logs.i40sys.com/loki/api/v1/push)
- Características adicionales:
- Configuración de etiquetas para identificar fuentes de logs y métricas
- Uso de descubrimiento Docker para identificar contenedores automáticamente
- Configuración de WAL (Write-Ahead Log) para Loki para mejorar la resiliencia
- Habilitación de depuración en vivo
Interface Web de Grafana Alloy
Alloy dispone de una UI que nos permite debugar la configuración que se ha definido en el fichero de configuración.
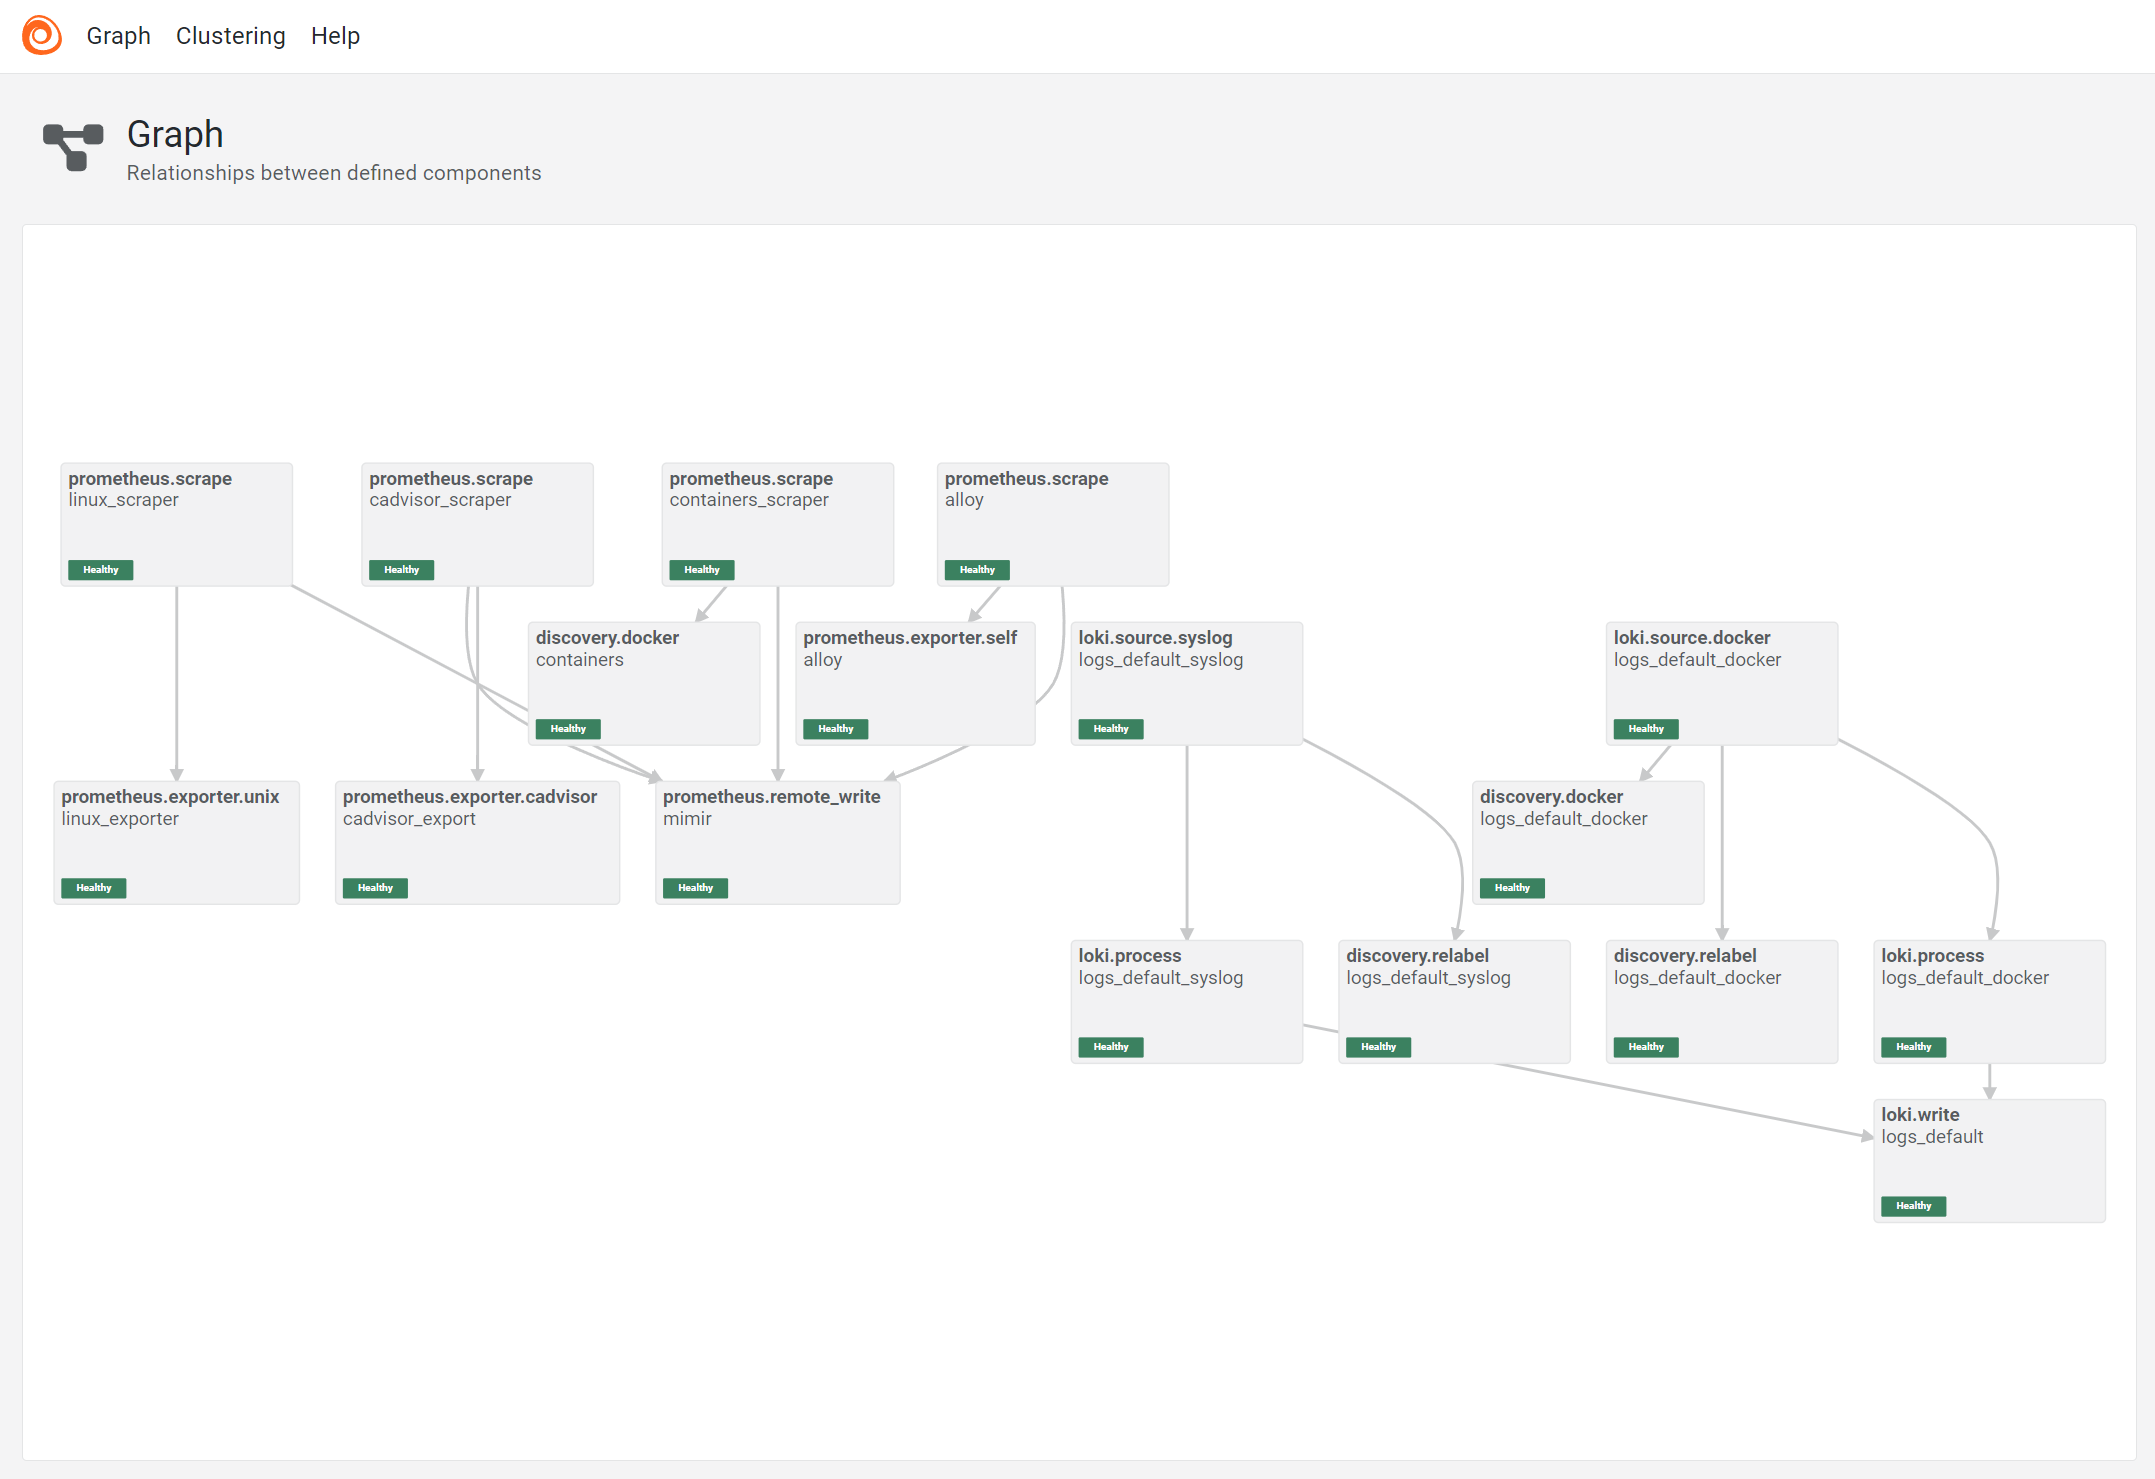
La interface esta disponible en el puerto
12345 .